SQL Server execution plan nedir?
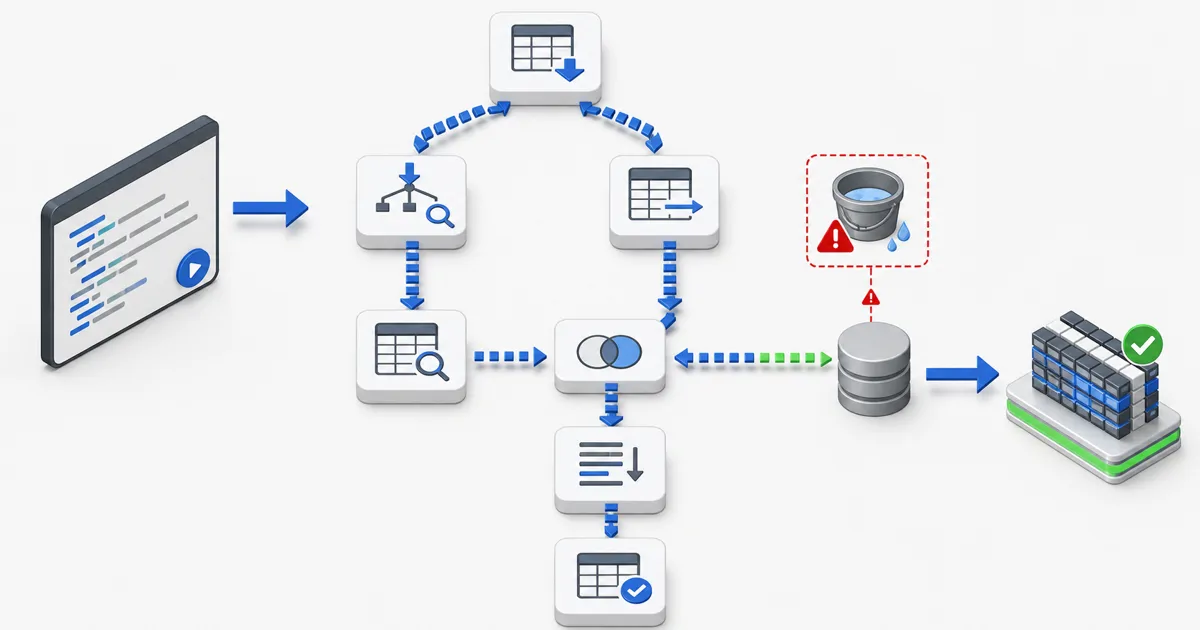
Execution plan, SQL Server sorgu iyileştiricisinin bir T-SQL ifadesini çalıştırmak için seçtiği fiziksel operatörler ağacıdır. Hangi tablonun önce okunacağını, veriye hangi erişim yöntemiyle ulaşılacağını, satırların nasıl birleştirileceğini ve sıralama ya da toplama gibi işlemlerin nerede yapılacağını gösterir.
Planı yalnız “en pahalı yüzde hangi operatörde?” sorusuyla okumak yanıltıcıdır. Doğru inceleme; planı, gerçek satır sayısını, mantıksal okumaları, süreyi, beklemeleri ve sunucu yükünü birlikte değerlendirir. Plan maliyeti süre ölçümü değil, iyileştiricinin karşılaştırma yapmak için kullandığı tahmindir.
Estimated ve actual execution plan farkı
| Plan | Sorguyu çalıştırır mı? | Gösterdiği temel bilgi | Ne zaman kullanılır? |
|---|---|---|---|
| Estimated plan | Hayır | İyileştiricinin tahmin ettiği operatör ve satırlar | Sorguyu çalıştırmak riskliyse veya ilk incelemede |
| Actual plan | Evet | Tahminlerin yanında çalışma zamanı ölçümleri | Süre, satır sapması ve operatör davranışı doğrulanırken |
Actual plan “tamamen gerçek bir plan” adıyla ayrı bir plan üretmez. Sorgunun seçilen planına çalışma zamanı istatistikleri eklenir. Bu nedenle actual planı production'da almak, sorguyu gerçekten çalıştırır; değiştiren bir ifade ise veriyi de değiştirebilir.
SSMS içinde:
Ctrl+L: estimated execution planı gösterir.Ctrl+M: Include Actual Execution Plan seçeneğini açar; sorgu çalıştırıldıktan sonra plan sekmesi oluşur.- Planın XML biçimi kaydedilebilir ve başka bir ortamda incelenebilir; XML içinde sorgu metni veya nesne adları bulunabileceği için paylaşmadan önce hassas veriyi temizleyin.
Ölçümden önce güvenli bir başlangıç oluştur
Önce sorguyu ve parametreleri kaydedin. Production verisinde DBCC FREEPROCCACHE veya
DBCC DROPCLEANBUFFERS çalıştırmayın; bu komutlar yalnız hedef sorguyu değil, ortak
sunucu önbelleklerini etkiler. Soğuk ve sıcak önbellek farkı gerekiyorsa izole test
ortamı kullanın.
SET STATISTICS IO ON;
SET STATISTICS TIME ON;

SELECT p.Id, p.Title, p.PublishedAt
FROM dbo.Posts AS p
WHERE p.Status = 1
  AND p.PublishedAt >= @StartDate
ORDER BY p.PublishedAt DESC;

SET STATISTICS TIME OFF;
SET STATISTICS IO OFF;
STATISTICS IO çıktısındaki logical reads, veri sayfalarının buffer pool üzerinden
kaç kez okunduğunu anlamaya yardımcı olur. CPU time ve elapsed time tek koşuda karar
vermek için yeterli değildir; aynı parametrelerle birden fazla kontrollü ölçüm alın.
Plan hangi yönde okunur?
SSMS grafik planında veri akışı oklarla gösterilir. Çoğu yatay planda yaprak operatörler sağda, sonuç operatörü soldadır; ancak ezberlenen “sağdan sola oku” kuralı yerine okların yönünü izlemek daha güvenlidir. Önce en dıştaki SELECT/INSERT/UPDATE sonucunu, sonra girdileri üreten dalları takip edin.
Ok kalınlığı taşınan satır miktarını yaklaşık olarak görselleştirir. Tek başına kalın ok hata değildir; beklenenden çok satırın pahalı bir operatöre taşınması araştırılması gereken sinyaldir.
İlk bakılacak dört alan
1. Actual Rows ile Estimated Rows farkı
Operatör özelliklerinde tahmin edilen ve gerçekleşen satır sayılarını karşılaştırın. Büyük sapma; güncel olmayan istatistik, çarpık veri dağılımı, ilişkili kolonlar, parametre duyarlılığı veya karmaşık ifadeler nedeniyle oluşabilir. Sapma plan ağacının erken bir noktasındaysa sonraki join, bellek tahsisi ve paralellik kararlarını da etkileyebilir.
Tek bir “yüzde sapma eşiği” her sistem için doğru değildir. 1 satır yerine 100 satır ile 1 milyon yerine 100 milyon satır aynı oranı verse de operasyonel etkileri farklıdır.
2. Erişim operatörü
- Index Seek: Arama koşuluna uygun anahtar aralığına gider. Genellikle seçici koşullarda iyidir; seek sonrası çok sayıda satır veya ek predicate varsa otomatik olarak ucuz sayılmaz.
- Index Scan: İndeksin önemli bölümünü okur. Küçük tablo, geniş sonuç veya uygun indeks olmadığında doğru seçim olabilir.
- Table Scan: Heap üzerinde taramadır. Büyük tabloda az satır bekleniyorsa indeks tasarımı ve predicate incelenir.
- Key Lookup / RID Lookup: Başka bir indekste bulunan anahtarla eksik kolonları getirir. Az tekrarda makuldür; binlerce kez çalışırsa okuma maliyetini büyütebilir.
“Scan gördüm, indeks eklemeliyim” doğru bir kural değildir. Dönen satır oranı, tablo boyutu, yazma maliyeti ve mevcut indekslerin çakışması birlikte değerlendirilmelidir.
3. Join ve blocking operatörler
- Nested Loops: Dış girdide az satır ve iç girdide verimli arama olduğunda güçlüdür.
- Hash Match: Büyük ve sıralanmamış veri kümelerinde uygun olabilir; yetersiz bellek verilirse tempdb'ye spill yapabilir.
- Merge Join: Her iki girdi uygun sıradaysa verimlidir; sırayı üretmek için pahalı Sort gerekiyorsa toplam maliyet değişir.
- Sort: Sonraki operatörün istediği sırayı üretir ve bellek tüketir.
- Spool: Ara sonucu tempdb'de tutup yeniden kullanabilir. Koruyucu ve doğru bir operatör de olabilir; yüksek tekrar ve büyük veri hacminde nedenini araştırın.
4. Warning bilgileri
Plan özellikleri ve uyarı simgelerinde şunları kontrol edin:
- sort veya hash spill;
- implicit conversion;
- eksik indeks önerisi;
- aşırı ya da yetersiz memory grant;
- çalışma zamanı hataları ve paralellik bilgileri.
Implicit conversion filtrelenen kolon üzerinde gerçekleşiyorsa indeks erişimini
engelleyebilir. Uygulama parametresinin SQL veri türü ile kolon türünü eşleştirmek,
kolonu CAST ederek aramaktan çoğu zaman daha sağlıklıdır.
SARGable predicate örneği
Kolona fonksiyon uygulamak arama aralığının kullanılmasını zorlaştırabilir:
-- İndeks kullanımını zorlaştırabilen biçim
WHERE YEAR(p.PublishedAt) = 2026;

-- Aralık aramasına uygun biçim
WHERE p.PublishedAt >= '20260101'
  AND p.PublishedAt <  '20270101';
Tarih sabitini dil ayarından etkilenmeyen biçimde vermek ve parametre kullanmak, uygulama kodunda hem doğruluk hem plan yeniden kullanımı açısından önemlidir.
Key Lookup ne zaman düzeltilmeli?
Key Lookup görüldüğünde önce Actual Number of Executions ve dönen satır sayısına bakın. Az sayıda lookup, bütün sorguların yazma maliyetini artıracak geniş bir indeksten daha ucuz olabilir. Etki yüksekse seçenekler şunlardır:
- Sorguda kullanılmayan kolonları
SELECT *yerine çıkarmak. - Arama ve sıralama kolonlarına uygun bileşik indeks tasarlamak.
- Yalnız sonuç için gereken kolonları
INCLUDElistesine almak. - Benzer mevcut indekslerle birleştirme olasılığını incelemek.
CREATE INDEX IX_Posts_Status_PublishedAt
ON dbo.Posts (Status, PublishedAt DESC)
INCLUDE (Title);
Bu indeks yalnız örnektir. Gerçek sisteme eklemeden önce sorgu kümesi, indeks boyutu, INSERT/UPDATE maliyeti ve mevcut indeksler ölçülmelidir. Execution plan içindeki missing index önerisi de sorgu bazlı bir ipucudur; otomatik değişiklik talimatı değildir.
Parameter sniffing yerine parameter sensitivity düşün
SQL Server ilk derleme sırasında görülen parametre değerlerine göre bir plan seçebilir. Veri dağılımı çok farklıysa bir değer için iyi olan plan başka değer için kötü olabilir. Sorunu kanıtlamak için:
- aynı sorguyu tipik küçük ve büyük sonuç üreten parametrelerle ölçün;
- Query Store içinde plan ve çalışma zamanı dağılımını karşılaştırın;
- istatistiklerin güncelliğini ve histogramı kontrol edin;
- uygulamanın parametre veri türü ve uzunluğunu doğrulayın.
OPTION (RECOMPILE), OPTIMIZE FOR veya plan zorlama doğrudan ilk çözüm değildir.
Derleme CPU maliyeti, plan kararlılığı ve sürümün Parameter Sensitive Plan özellikleri
değerlendirilmeden kalıcı hint eklenmemelidir.
Query Store ile gerilemeyi bul
Query Store; sorgu metinlerini, planları ve çalışma zamanı istatistiklerini zaman içinde saklayarak sürüm veya indeks değişikliği sonrası gerilemeyi incelemeyi kolaylaştırır. Bir planı zorlamadan önce eski ve yeni zaman aralıklarında yürütme sayısı, ortalama ve uç değer süreler, CPU, logical reads ve plan değişimini birlikte karşılaştırın.
Plan zorlama geçici bir emniyet olabilir; kök neden ortadan kalkınca eski planı kalıcı tutmak yeni veri dağılımına zarar verebilir. Bu nedenle kararın sahibi, izleme metriği ve kaldırma koşulu kayıt altına alınmalıdır.
Uçtan uca inceleme sırası
- Yavaş sorgunun gerçek metnini, parametresini ve zaman aralığını kaydet.
- Beklenen sonuç kümesini ve iş yükü sıklığını doğrula.
- Actual plan,
STATISTICS IOveSTATISTICS TIMEölçümlerini birlikte al. - Planın uyarılarını ve satır tahmini sapmasının başladığı ilk operatörü bul.
- Predicate veri türlerini, SARGability ve istatistikleri kontrol et.
- Erişim, lookup, join, sort/spill ve memory grant etkisini sırayla değerlendir.
- En küçük güvenli değişikliği test verisinde uygula.
- Aynı parametre ve koşullarla önce/sonra ölçümü yap.
- Yazma maliyeti, plan önbelleği ve diğer kritik sorgularda gerileme olmadığını test et.
- Geri dönüş komutunu, ölçüm sonucunu ve gözlem süresini kaydet.
Sık yapılan hatalar
- Yalnız en yüksek maliyet yüzdesine bakmak.
- Her scan operatörünü kötü kabul etmek.
- Missing index önerilerinin tamamını üretime eklemek.
- Actual plan alırken veri değiştiren sorgunun gerçekten çalışacağını unutmak.
- Testte farklı parametre, farklı veri hacmi veya farklı compatibility level kullanmak.
- Önbelleği ortak production sunucusunda temizlemek.
- Süreyi ölçüp logical reads, CPU, bekleme ve yürütme sıklığını yok saymak.
- Plan XML'ini hassas sorgu metniyle herkese açık paylaşmak.
İlgili rehberler
- SQL Server performans konu merkezi
- Dapper mı ADO.NET mi?
- Entity Framework olmadan temiz veri erişim katmanı
- Controller içine SQL yazmadan Dapper mimarisi
Resmî kaynaklar
- Microsoft Learn: Execution plans
- Microsoft Learn: Display and save execution plans
- Microsoft Learn: SET STATISTICS IO
- Microsoft Learn: SET STATISTICS TIME
- Microsoft Learn: Monitor performance with Query Store
Güncellik notu
Bu rehber Ağustos 2026'da SQL Server ve SSMS davranışını açıklayan resmî Microsoft dokümantasyonu esas alınarak gözden geçirilmiştir. Operatör ayrıntıları compatibility level, Cardinality Estimator ve SQL Server sürümüne göre değişebilir; üretim kararı hedef ortamın kendi ölçümüyle verilmelidir.